Como acelerar el arranque de una persona en un nuevo proyecto

En esta ocasión quería comentar una herramienta para configurar y distribuir servidores. Concretamente la herramienta se llama Docker

Para ver qué es lo que nos puede aportar Docker vamos a plantear una problemática muy común en las empresas de desarrollo.

Llega una nueva persona al equipo del proyecto y… ¿ cual es una de las primeras cosas que suele tener que hacer ?,… efectivamente, ponerse el entorno.

En muchos sitios este trámite consiste en que algún compañero le haga un zip de su servidor y de su herramienta de desarrollo y se lo pase.

El compañerismo está muy bien, pero esta forma de proceder no es la más adecuada, porque se acaba arrastrando mucha porquería, ya que no es un entorno limpio.

Sin contar que tampoco suele haber ningún mecanismo para tener actualizado el entorno. Así que cuando se libera una nueva versión de alguna librería o del servidor toca actualizarse manualmente.

Y aquí entramos en:

– personas que no lo hacen porque tienen que entregar algo sin falta y van apurados.
– o personas que al seguir el manual de como actualizar se equivocan.
– o simplemente personas que tiene montado el entorno a su manera.

Total que con esta forma de proceder el tener un entorno actualizado es casi una quimera o de conseguirse el coste es muy alto. Y estas operaciones se repiten bastante a menudo dentro de un proyecto un poco grande y largo.

Pero hay soluciones, una de las que más auge está tomando últimamente es Docker.

Tengo un ejemplo muy simple, en youtube, que consiste en un servidor WildFly, que es la versión de la comunidad del JBoss, con un módulo instalado para obtener métricas de la ejecución de nuestra aplicación, que viene a simular las librerías específicas de un proyecto y una aplicación muy sencilla de ejemplo.

Las herramientas que se usan en este vídeo son las siguientes:
– Docker versión 1.9
– Docker Hub
– JBoss Developer Studio 9.0.0
– WildFly 9.0.2
– Dropwizard metrics

Espero que os sirva de ayuda, y no dudes en dar a like y compartirlo.

Añadidos a la biblioteca

He actualizado los libros de cabecera con varios ejemplares de la editorial Manning.

Me gusta especialmente la serie In Action. Todos los libros que tengo de esta serie son introductorios pero bastante completos. Escrito de una forma bastante clara, incluso para alguien que su idioma materno no es el Inglés.

Empecé con el libro de Camel in Action  que no he llegado a terminar, pero me sirvió para tener una visión bastante interesante de la herramienta y sus posibilidades.

De este primer libro y la grata impresión que me dejó han ido derivando una serie de compras más.

Cuando te dedicas a temas de tecnología y más si están en el candelero uno de los problemas es que los libros suelen estar un poco desfasados, ya que lleva su tiempo escribirlos. Pero esta editorial tiene un programa que se llama MEAP que es el acrónimo de Manning Early Access Program, que te permite disponer de los libros que están escribiendo, lógicamente sólo los capítulos que tienen escritos. Hay erratas y dibujos hechos a boli pero puedes acceder al contenido existente.

Tengo los libros de Docker in Action y Elasticsearch in Action que me han parecido fantásticos. El libro de Docker In Practice me ha decepcionado un poco, en vez de ser un manual al uso son más bien recetas, de situaciones y cómo resolverlas. Teniendo su equivalente in Action, me parece que no aporta mucho.

Ahora mismo estoy leyendo Unified Log Processing que me está resultando muy interesante, aunque no está más que la mitad de los capítulos. Pero lo que he leído me ha resultado de mucha ayuda.

El siguiente que tengo en la recámara es el de Big Data, que ni he empezado.

Una de las cosas buenas de comprar a la editorial directamente es que suelen hacer descuentos asiduamente, con lo que fácilmente te ahorras un 40%. Esto no sería posible en España, porque está prohibido aplicar un descuento de más del 10%. Lástima por los comerciantes españoles…

ElasticWeather: tratamiento de datos meteorológicos con elasticsearch y docker

Ha habido un gran parón desde mi anterior entrada en el blog y esta.

Siempre he pensado que aunque se recomiende tener actividad regularmente es más importante el hecho de que el contenido sea de calidad a la cantidad. No vivo de esto sino que es un complemento, así que aunque aprecio el número de vistas, no me obsesiona.

Durante estos meses me he dedicado a ampliar mis conocimientos en las dos áreas en las que me he especializado, que son los temas de devops y la arquitectura de aplicaciones. Procuro mantener un cierto nivel en un rango amplio de materias, pero es complejo ya que requiere de tiempo y es finito. Así que ya desde hace unos cuantos años, y no sin cierta pena, suelo hacer descartes.

Así que he estado ampliando conocimientos en ámbas áreas, concretamente en la parte de devops con Docker y en la parte de arquitectura con BigData.

El tema del BigData lo llevo mirando desde hace ya bastante tiempo, pero sin poder dedicarle todo el tiempo que me hubiese gustado. Ahí están como muestra las pruebas de concepto de la serie weather a la que he añadido elasticWeather para tratar los datos meteorológicos con elasticSearch.

Y para matar dos pájaros de un tiro y cubrir la parte de devops esta prueba de concepto de elastic está implementada utilizando contenedores docker. Así que cualquiera que quiera trastear con elasticWeather le va a resultar mucho más sencillo disponer de la infraestructura.

Docker lo que nos permite es plataformar servidores y distribuir de una forma relativamente sencilla esa plataforma. Esto es ideal para que los equipos de desarrollo empiecen a ser productivos con rapidez.

Pero aparte del proyecto en gitHub he hecho dos vídeos, uno más centrado en el elastic, concretamente en el Kibana y otro más centrado en la infraestructura utilizada, es decir en el Docker.

Si necesitas una formación formal en Docker dispongo de un curso completo de 7 horas en el que podrás tener un certificado de finalización y un contenido más hilvanado que las píldoras de Youtube. También me ayudarás a mantener este web y la elaboración de los vídeos en Youtube.

La descripción completa y las plataformas en las que está disponible el curso las podéis ver arriba en el menú de curso.

Os los dejo a continuación. Como siempre son bienvenidos los likes, las suscripciones y los comentarios constructivos.


Cual es el porcentaje adecuado de cobertura de código

En mi opinión, lo mejor que puedes hacer es olvidarte del porcentaje de cobertura de código. Me explico.

Cuando lees el libro de Kent Beck, que es el autor que puso de moda las pruebas unitarias, y que viene a ser el manifiesto de programación extrema, te das cuenta que no habla en ningún momento de porcentajes de cobertura. El lo que dice es qué hay que escribir todas las pruebas que se te ocurran, de cosas que pueden fallar, obviamente. Y una vez que el código pasa todas esas pruebas y no eres capaz de encontrar ninguna prueba más tu código ya es correcto.

A la hora de probar nuestro código existe un grupo de herramientas que son las de cobertura de código que nos ayudan en nuestro trabajo. Estas herramientas, en el caso de Java, lo que hacen es poner la máquina virtual en un modo en el que la máquina va diciendo por que líneas de código va pasando cuando se ejecuta código. De tal forma que si nosotros ejecutamos nuestras pruebas unitarias con una herramienta de cobertura de código y vemos que hay una serie de líneas de código por las cuales no se ha pasado, eso nos proporciona una información muy valiosa. Puede ser por dos motivos o bien nuestro juego de ensayo no es tan completo como nosotros creíamos y se nos ha escapado alguna casuística o bien es lo que se llama código muerto, es decir en algún momento ese código tuvo alguna utilidad pero en este momento ya no la tiene y no se usa y se puede eliminar.

El problema viene cuando se confunde un medio con un fin es decir el fin de las pruebas unitarias es asegura que código es correcto la cobertura del código es un medio. Si nos obsesionamos con los porcentajes con un 70% o 60% u 80% de cobertura es cuando estamos equivocando el medio y el fin.

Obviamente si nuestra cobertura de código es baja es prácticamente imposible que nuestro juego de ensayos sea completo ya que hay muchas líneas por las cuales no pasamos. Pero también se puede dar el caso inverso, es decir que hayamos pasado por todas las líneas de código no quiere decir que las condiciones que hemos puesto en el JUnit sean las correctas o todas las necesarias. De hecho podríamos poner como única condición el siempre valido assertTrue(true) y nuestra cobertura de código sería alta.

Es por ello que, como decía al principio, no creo que haya que darle especial importancia al porcentaje de cobertura. Si es un buen indicador pero necesita de una persona que supervise porque él nivel es bajo o si un nivel alto realmente me está asegurando la calidad.

MongoWeather: Infraestructura en la nube con RedHat OpenShift

Hoy traigo un videotutorial sobre la infraestructura para la prueba de concepto de tratamiento de datos meteorológicos con MongoDB.

Normalmente las pruebas las suelo realizar sobre máquinas virtuales, para no saturar la máquina física. Pero el otro día hablando con los chicos de RedHat que están en el trabajo me propusieron otra opción. Esta opción consiste en utilizar la nube que tiene RedHat. Al final viene a ser la misma solución salvo que en vez de tener una máquina virtual en mi máquina la tengo en la nube, con lo cual, es accesible para el resto del mundo y ya no necesito sobrecargar mi máquina.

En muy poco tiempo, unos 15 minutos, disponemos de una máquina perfectamente configurada y disponible en Internet que incluye un servidor de aplicaciones, una base de datos mongoDB y una herramienta de administración de esa base de datos en este caso rockMongo.

Todo por supuesto completamente gratis es una máquina pequeñita de un giga y 500 megas de RAM pero para la prueba de concepto es suficiente.

Espero que os guste.

Puntos de interrupción condicionados

Esta entrada es sobre un pequeño truco que no mucha gente conoce y que resulta bastante útil. Se trata de como tener puntos de interrupción que hagan que nuestro JBoss Developer Studio / Eclipse se pare cuando se produce una condición.

Supongamos que, por ejemplo, se nos produce un error porque en un determinado punto de nuestro programa una variable vale nulo. Pero ese valor no se da siempre, sino que es en determinadas condiciones que no tenemos claras y no siempre que pasamos por ese punto se produce el valor nulo, o estamos en un bucle, por ejemplo.

La forma de ayudarnos que tiene el eclipse es con los puntos de interrupción con condiciones.

Tomemos como ejemplo el siguiente código:

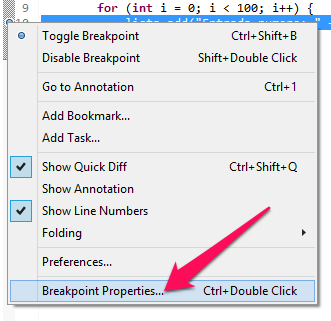
Queremos que se pare la ejecución, solo cuando la variable i vale 15. Para ello ponemos un punto de interrupción en la línea 10 y con el botón derecho mostramos las opciones del punto de interrupción.

Se nos mostrará la siguiente ventana en la que podremos indicarle que queremos un punto de interrupción condicionado y podremos escribir la condición, en este caso que i sea igual a 15
Cuando depuremos el código veremos que se nos para cuando se cumple la condición de que la variable valga 15
Espero que os haya resultado útil este pequeño truco.
Os dejo aquí un pequeño video en el que se puede ver esto mismo en ejecución. 

.

Nuestro rol como clientes y proveedores y sus paradojas

En la vida de cada uno de nosotros en la mayor parte de las situaciones somos consumidores de productos o servicios. Compramos cosas, como ropa, electrónica, etc, o bien contratamos servicios, como por ejemplo la línea telefónica.

Y normalmente somos exigentes con las compañías que nos prestan estos servicios. Es lo normal, pagamos por un producto y servicio y queremos que nos lo presten correctamente. A nadie le gusta quedarse sin cobertura en el teléfono, o que no le funcione el terminal, o que el medico no le diagnostique bien, o un largo etcetera.

A veces lo que nos ocurre como trabajadores es que no nos damos cuenta que en ese momento nosotros somos los prestadores del servicio. Y lógicamente nuestros clientes van a tener un nivel de exigencia similar al que nosotros tendríamos si fuésemos los clientes. Y se nos suele olvidar.

¿Que pensaríamos si estamos reformando la cocina de nuestra casa y el albañil cuando llega la fecha de entrega nos dice que va a tardar más? Lógicamente lo más probable es que no nos parezca bien, no vamos a disponer de nuestra cocina, con el trastorno que nos supone, y encima nos va a costar más, porque obviamente el albañil no va trabajar gratis.

Pero me he encontrado con casos en este sector de la informática en los que gente del equipo se permite plantear que se le pida más tiempo al cliente. Y lo más curioso es que luego cuando las cosas van mal y el cliente te echa se extrañan.

Pero ¿alguien mantendría o volvería a contratar al albañil que obviamente está siendo incapaz de llevar la reforma de la cocina a cabo?.

MongoWeather: Carga de la información

El siguiente paso para poder procesar los datos de la estación meteorológica con mongoDB, después de tener instalada la infraestructura, es proceder a cargar los datos.

El programa de la estación meteorológica permite exportar los datos en formato CSV, es decir separado por comas. Y este formato es soportado por la utilidad de importación de mongoDB.

Con lo que tan solo con un comando debiera de ser suficiente:

mongoimport -d weather -c weather –type csv –file ./EasyWeather.csv –headerline

Con esto le decimos que importe los datos en la base de datos weather y la coleccion es también weather. Así mismo le decimos que el formato es csv, que la primera línea tiene el nombre de los campos y cual es el fichero que queremos importar.

Con esta información nos importará los datos, pero…

Vemos que hay ciertos datos que no los ha importado correctamente.
Podríamos modificarlos en origen con algún conjuro (sed -e ‘s/ /g’ o similar) de Linux, pero vamos a darle una solución con mongoDB.
Esta solución se basa en un cursor, que recorre todos los registros y los va modificando para convertir los String en fechas.
El script es este (está también disponible en la página de GitHub):
Con este cursor creamos un string con el formato adecuado y con el creamos el objeto Date para que mongoDB lo gestione como lo que es.
Seguimos teniendo otro problema, y es que cuando no existen datos la exportación del programa de la estación meteorológica pone un texto «—«. Pero como es una substitución simple, podemos hacerlo con una update más sencilla

MongoWeather: Instalación

El primer paso para poder almacenar y tratar los datos de la estación meteorológica con mongoDB es… tener instalado el mongoDB.

Yo he utilizado para tener el servidor un CentOS versión 7. En la página de mongoDB hay instrucciones para realizar la instalación.

Solo añadir que por defecto no escucha más que en el interface localhost, es decir 127.0.0.1 Para permitir que se pueda llamar desde otra máquina hay que cambiar una linea en el fichero de configuración /etc/mongod.conf

Con esto solo tendremos que reiniciar el servidor y comprobar que se arranca correctamente.

Como cliente estoy usando roboMongo pero eso si desde una máquina windows porque con el CentOS no me dejaba instalarlo por problemas de dependencias.

En este caso ya hay ciertos datos cargados, pero eso en la próxima entrada

MongoWeather

Hace unas entradas comenté que estaba realizando una prueba de concepto de BigData en la que lo que pretendía era probar las posibilidades del MapReduce.

Inicialmente lo empecé a implementar utilizando la herramienta Infinispan/JBoss Data Grid pero me he encontrado con bastantes dificultades, no tanto por el soporte de MapReduce, sino por la carencia de herramientas auxiliares que facilitaran el trabajo.

Es por ello que he decidido utilizar otra herramienta que me permite realizar el mismo tipo de pruebas pero sin requerir de tanto trabajo auxiliar.

Esta herramienta es MongoDB. Tiene una serie de ventajas sobre Infinispan para mis propositos:
– Me permite cargar los datos en la base de datos sin tener que realizar ningún tipo de desarrollo, utilizando la herramienta mongoimport.
– Me permite realizar los scripts en javascript de forma nativa, sin tener que realizar ningún tipo de desarrollo a medida

De esa forma me permite concentrarme en la parte de mapReduce que es la que más me interesa. De momento he conseguido con mucha menos dedicación de tiempo implementar lo que con Infinispan me ha costado bastante más.

El, de momento, poco código está aqui.